کوانتیزاسیون (Quantization)

مدلهای هوش مصنوعی روزبهروز پیچیدهتر میشوند و اغلب از توانایی سختافزارهای موجود فراتر میروند. کوانتیزاسیون (Quantization) راهکاری حیاتی برای رفع این چالش است که به مدلهای سنگین اجازه میدهد روی سختافزارهای محدود اجرا شوند. با…
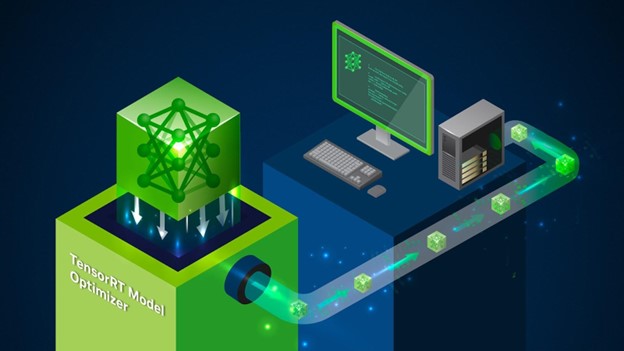
مدلهای هوش مصنوعی روزبهروز پیچیدهتر میشوند و اغلب از توانایی سختافزارهای موجود فراتر میروند. کوانتیزاسیون (Quantization) راهکاری حیاتی برای رفع این چالش است که به مدلهای سنگین اجازه میدهد روی سختافزارهای محدود اجرا شوند. با استفاده از ابزارهایی مانند NVIDIA TensorRT و Model Optimizer، میتوان ضمن حفظ دقت، کارایی مدل را به حداکثر رساند.
مزایای کوانتیزاسیون
کوانتیزاسیون با کاهش دقت پارامترها (مثلاً از FP32 به FP8)، امکان اجرای مدلهای سنگین هوش مصنوعی را روی سختافزارهای محدود فراهم میکند. این تکنیک با کوچکتر کردن حجم مدل، منجر به افزایش سرعت استنتاج و کاهش مصرف انرژی میشود. اگرچه این فرآیند ممکن است افت دقت ناچیزی به همراه داشته باشد، اما انتخاب سطح مناسب کوانتیزاسیون، تعادل بهینهای بین کارایی و دقت برای کاربردهای مختلف ایجاد میکند.
انواع دادهها در کوانتیزاسیون
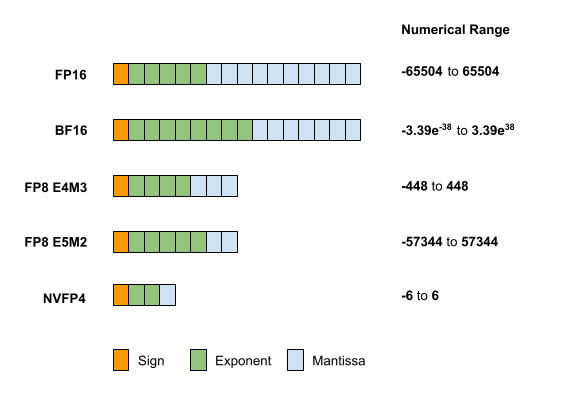
انواع داده (مانند FP32, FP16, FP8) مستقیماً بر منابع محاسباتی مورد نیاز تأثیر گذاشته و هم سرعت و هم کارایی مدل را تحت تأثیر قرار میدهند. چندین فرمت ممیز شناور (Floating-point) میتوانند برای نمایش پارامترهای مدل استفاده شوند. فرمتهای رایج شامل FP32، FP16، BF16 و FP8 هستند. بهطور معمول، یک عدد ممیز شناور از n بیت برای ذخیره یک مقدار عددی استفاده میکند که به سه جزء تقسیم میشود:
- علامت (Sign): این تکبیت، علامت عدد را نشان میدهد؛ ۰ برای مثبت و ۱ برای منفی.
- توان (Exponent): این بخش توان را کدگذاری میکند که نشاندهنده توانی است که پایه (معمولاً ۲ در سیستمهای باینری) به آن رسیده و محدوده (Range) نوع داده را تعریف میکند.
- مانتیس/معنادار (Significand/Mantissa): این بخش ارقام معنادار عدد را نشان میدهد. دقت عدد بهشدت به طول مانتیس بستگی دارد.
نقاط کلیدی برای بهینهسازی مدل
کوانتیزاسیون تنها به وزنهای مدل محدود نمیشود؛ برای دستیابی به حداکثر کارایی در مدلهای ترنسفورمر، میتوان علاوه بر وزنها، بر «فعالسازهای میانی» و «حافظه پنهان KV» نیز تمرکز کرد تا مصرف حافظه و زمان استنتاج بهطور چشمگیری کاهش یابد.
عناصر کلیدی قابل کوانتیزاسیون:
- وزنهای مدل (Model Weights): پارامترهای ثابت مدل هستند که با کاهش دقت آنها (مثلاً از FP16 به FP8)، حجم ذخیرهسازی مدل مستقیماً کاهش یافته و بارگذاری آن روی حافظه (VRAM) بهینه میشود.
- فعالسازهای مدل (Model Activations) : مقادیر پویای میانی هستند که در طول استنتاج تولید میشوند؛ کوانتیزه کردن آنها سرعت محاسبات را با بهرهگیری از سختافزارهای تخصصی (مثل Tensor Cores) بهشدت افزایش میدهد.
- حافظه پنهان KV (KV Cache): در مدلهای دیکودر برای جلوگیری از محاسبه مجدد توکنهای قبلی استفاده میشود؛ کوانتیزاسیون آن به مدیریت بهتر حافظه در ورودیهای طولانی (Context Length) و افزایش سرعت تولید توکن کمک میکند.
الگوریتم کوانتیزاسیون: تبدیل اعداد بزرگ به کوچک
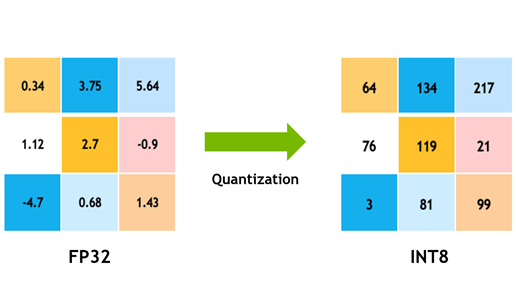
کوانتیزاسیون یعنی تبدیل اعدادِ دقیق و بزرگ (با دقت بالا) به اعداد سادهتر و کوچکتر (با دقت پایین). این کار شبیه به گرد کردن اعداد اعشاری است تا فضای کمتری اشغال کنند.
چگونه این تبدیل انجام میشود؟
در این فرآیند، بازهی گستردهای از اعداد (مثلاً اعداد بسیار بزرگ در مدلهای اصلی) را به بازهی کوچکتری که سختافزار میتواند سریعتر پردازش کند، «نگاشت» یا منتقل میکنیم.
یک مثال ساده:
فرض کنید مدل شما اعدادی بین ۶۵۵۰۴- تا ۶۵۵۰۴+ دارد. ما این اعداد را به بازه کوچکترِ ۴۴۸- تا ۴۴۸+ تبدیل میکنیم.
نتیجه: با این کار، مدل همان اطلاعات را در فضای بسیار کمتر و با سرعت بیشتری پردازش میکند، بدون اینکه ماهیت اصلی محاسبات تغییر کند.
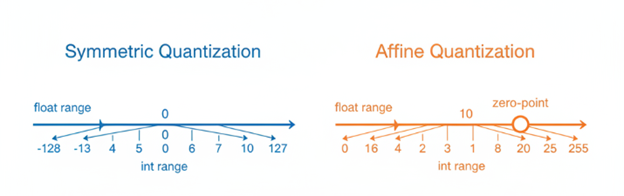
برای انجام دقیق این تبدیل، از دو روش اصلی استفاده میشود که تفاوتشان در چگونگی تنظیم این “بازهها” و “نقطه صفر” است: روش متقارن (سادهتر و سریعتر) و روش افاین/نامتقارن (دقیقتر).
. کوانتیزاسیون متقارن (Symmetric)
این روش مثل یک ترازو است که دقیقاً در وسط قرار دارد.
- چگونه کار میکند؟ عدد «صفر» در مدل دقیقاً همان عدد «صفر» در مدل کوانتیزه شده است. ما فقط سعی میکنیم بزرگترین مقدار مثبت و منفی را به لبههای بازهی جدیدمان (مثلاً ۴۴۸ و ۴۴۸-) برسانیم.
- مزیت: بسیار ساده و سریع است. چون نقطه صفر تغییر نمیکند، محاسبات ریاضی برای پردازنده بسیار راحتتر انجام میشود.
- عیب: اگر اعداد مدل شما فقط مثبت باشند یا توزیعشان به شکلی باشد که صفر در وسطِ بازهی عددی نباشد، این روش دقت زیادی را هدر میدهد.
۲. کوانتیزاسیون نامتقارن(affine)
این روش انعطافپذیرتر است و سعی میکند با شرایطِ دادهها خودش را تطبیق دهد.
- چگونه کار میکند؟ علاوه بر ضریب مقیاس (Scale)، یک «نقطه صفر» (Zero-point) هم داریم. این نقطه صفر به ما اجازه میدهد که بازهی اعداد را کمی جابهجا کنیم تا دقیقاً روی دادههای ما بنشیند؛ یعنی لزوماً صفرِ مدلِ دقیق، صفرِ مدلِ کوانتیزه شده نیست.
- مزیت: بسیار دقیقتر است، چون میتواند بازهی اعداد را کاملاً بر اساس توزیع دادههای واقعی مدل تنظیم کند (حتی اگر دادهها همگی در یک سمتِ نمودار جمع شده باشند).
- عیب: به دلیل وجود «نقطه صفر»، محاسبات ریاضی در حین اجرا کمی پیچیدهتر و سنگینتر میشود.
گرنولاریته (دانه بندی): چقدر ظریف عمل کنیم؟
اینکه چقدر از اعدادِ یک لایه را با یک تنظیمات واحد کوانتیزه کنیم، «دانه بندی» نام دارد. سه رویکرد اصلی داریم:
- در سطح تنسور (کلی): یک تنظیم برای کل لایه. سادهترین و سریعترین روش، اما به دلیل یکسانسازی همه اعداد، ممکن است دقت کمی افت کند.
- در سطح کانال (متوسط): هر کانالِ محاسباتی تنظیمات خاص خودش را دارد. این روش هوشمندانهتر است و جلوی اثر مخربِ «اعداد پرت» (اعداد بسیار بزرگ یا کوچک) را میگیرد.
- در سطح بلوک (ظریف): تنسور به بلوکهای کوچک تقسیم میشود. این دقیقترین روش است که اجازه میدهد تنظیمات به بهترین شکل با توزیعِ متغیرِ دادهها هماهنگ شود.
الگوریتمهای پیشرفته: حفظ دقت با هوشمندی
گاهی کوانتیزاسیون معمولی باعث افت کیفیت میشود. الگوریتمهای زیر برای جلوگیری از این اتفاق ساخته شدهاند:
- AWQ (محافظت از وزنهای حیاتی): میگوید همه وزنها برابر نیستند! این روش ابتدا وزنهای «مهمتر» (سالیانت) را شناسایی میکند و آنها را دستنخورده نگه میدارد یا با دقت بیشتری کوانتیزه میکند تا عملکرد مدل حفظ شود.
- GPTQ (دقتِ ریاضیِ بالا): این روش به جای تغییرِ سرسری اعداد، از فرمولهای پیچیده ریاضی (ماتریس هسین) استفاده میکند تا بفهمد با تغییرِ هر عدد، چقدر خطا در خروجی نهایی ایجاد میشود. سپس با محاسبات دقیق، آن خطا را به حداقل میرساند.
- SmoothQuant (هموارسازی): یک ترفند عالی! این روش «اعداد پرتِ» فعالسازها را که کوانتیزاسیون را سخت میکنند، کمی هموار کرده و فشار را به وزنها منتقل میکند. با این کار، هم وزنها و هم فعالسازها خیلی راحتتر به دقت ۸ بیت تبدیل میشوند.
هنرِ تعادل در هوش مصنوعی
کوانتیزاسیون فراتر از یک تکنیک فنی ساده، هنرِ «حذف جزئیات غیرضروری» برای دستیابی به سرعت و کارایی بالاست. همانطور که دیدیم:
۱. استراتژی محور است: انتخاب سطح دانه بندی (از کلی تا جزئی) و نوع الگوریتم، مستقیماً بر کیفیت و سرعت نهایی مدل تأثیر میگذارد.
۲. هوشمندسازی شده است: با روشهایی مثل AWQ، GPTQ و SmoothQuant، ما دیگر صرفاً با یک «گرد کردن» ساده روبرو نیستیم، بلکه با الگوریتمهایی سروکار داریم که با تحلیلِ دقیقِ وزنها و فعالسازها، کمترین آسیب را به هوش مدل وارد میکنند.
۳. توازنِ دقت و سختافزار: هدف نهایی کوانتیزاسیون، یافتن نقطهی طلایی است؛ جایی که مدل بتواند با حداقل حافظه و بیشترین سرعت، در دسترستر از همیشه باشد.
در نهایت، کوانتیزاسیون پلی است که مدلهای قدرتمند اما «سنگین» آزمایشگاهی را به مدلهای «سبک» و آمادهی اجرا روی گوشیها، لپتاپها و سختافزارهای محدودِ امروز تبدیل میکند. با تسلط بر این مفاهیم، شما نه تنها مدلهای بهینهتری خواهید داشت، بلکه مدیریت هزینهها و منابع پردازشی را نیز در دست میگیرید.
کوانتیزاسیون با کاهش دقت عددی مدل، حجم آن را کمتر میکند و باعث میشود مدل سریعتر، کممصرفتر و قابل اجرا روی سختافزارهای محدودتر باشد.
بله، اما معمولاً این افت بسیار ناچیز است. اگر نوع و سطح کوانتیزاسیون درست انتخاب شود، میتوان تعادل بسیار خوبی بین سرعت و دقت ایجاد کرد.
کوانتیزاسیون یکی از بهترین روشهاست، اما تنها راه نیست؛ روشهایی مثل هرسسازی(Pruning) و تقطیر دانش (Knowledge Distillation) هم برای سبکتر و سریعتر کردن مدل استفاده میشوند.